சில கேள்விகளை எப்போது தவிர்க்க வேண்டும் என்பதை அறிய இந்த முறை AIக்கு உதவுகிறது. வன்முறை அல்லது பாகுபாடு போன்ற தீங்கு விளைவிக்கும் உள்ளடக்கத்தை உள்ளடக்கிய கோரிக்கைகளை நிராகரிக்க இது கற்றுக்கொள்கிறது.
RLHF-ஐப் பயன்படுத்தும் ஒரு மாதிரிக்கு நன்கு அறியப்பட்ட உதாரணம் OpenAI-இன் ChatGPT ஆகும் . இந்த மாதிரி, பதில்களை மேம்படுத்தவும், அவற்றை மேலும் பொருத்தமானதாகவும் பொறுப்பானதாகவும் மாற்றவும் மனித பின்னூட்டத்தைப் பயன்படுத்துகிறது.
மனித பின்னூட்டத்துடன் வலுவூட்டல் கற்றலின் படிகள்
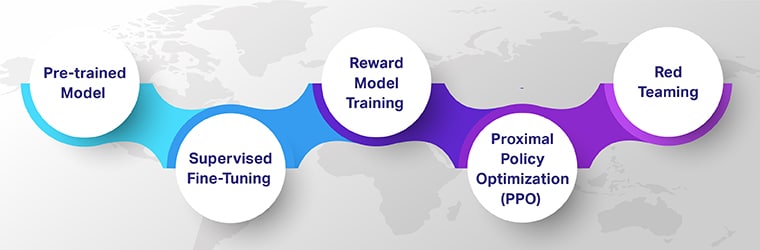
மனித பின்னூட்டத்துடன் கூடிய வலுவூட்டல் கற்றல் (RLHF) AI மாதிரிகள் தொழில்நுட்ப ரீதியாக திறமையானவை, நெறிமுறையில் சிறந்தவை மற்றும் சூழலுக்கு ஏற்றதாக இருப்பதை உறுதி செய்கிறது. RLHF இன் ஐந்து முக்கிய படிகளைப் பார்க்கவும், அவை அதிநவீன, மனித வழிகாட்டுதல் AI அமைப்புகளை உருவாக்குவதில் எவ்வாறு பங்களிக்கின்றன என்பதை ஆராயும்.
முன் பயிற்சி பெற்ற மாதிரியுடன் தொடங்குதல்
RLHF பயணம், மனித-இன்-தி-லூப் மெஷின் லேர்னிங்கில் ஒரு அடிப்படைப் படியான முன்-பயிற்சி பெற்ற மாதிரியுடன் தொடங்குகிறது. ஆரம்பத்தில் விரிவான தரவுத்தொகுப்புகளில் பயிற்றுவிக்கப்பட்ட இந்த மாதிரிகள் மொழி அல்லது பிற அடிப்படைப் பணிகளைப் பற்றிய பரந்த புரிதலைக் கொண்டுள்ளன, ஆனால் நிபுணத்துவம் இல்லாதவை.
டெவலப்பர்கள் முன் பயிற்சி பெற்ற மாதிரியுடன் தொடங்கி குறிப்பிடத்தக்க நன்மையைப் பெறுகின்றனர். இந்த மாதிரிகள் ஏற்கனவே பரந்த அளவிலான தரவுகளிலிருந்து கற்றுக் கொள்ளப்பட்டுள்ளன. இது ஆரம்ப பயிற்சி கட்டத்தில் நேரத்தையும் வளங்களையும் சேமிக்க உதவுகிறது. இந்த படிநிலையானது தொடர்ந்து கவனம் செலுத்தும் மற்றும் குறிப்பிட்ட பயிற்சிக்கான களத்தை அமைக்கிறது.
கண்காணிக்கப்படும் ஃபைன்-டியூனிங்
இரண்டாவது படியானது மேற்பார்வையிடப்பட்ட ஃபைன்-ட்யூனிங்கை உள்ளடக்கியது, அங்கு முன் பயிற்சி பெற்ற மாதிரி ஒரு குறிப்பிட்ட பணி அல்லது டொமைனில் கூடுதல் பயிற்சி பெறுகிறது. இந்தப் படியானது லேபிளிடப்பட்ட தரவைப் பயன்படுத்துவதன் மூலம் வகைப்படுத்தப்படுகிறது, இது மாதிரியானது மிகவும் துல்லியமான மற்றும் சூழல் சார்ந்த வெளியீடுகளை உருவாக்க உதவுகிறது.
இந்த நுண்ணிய-சரிப்படுத்தும் செயல்முறையானது, மனிதனால் வழிநடத்தப்படும் AI பயிற்சியின் ஒரு பிரதான எடுத்துக்காட்டு ஆகும், அங்கு மனித தீர்ப்புகள் AI ஐ விரும்பிய நடத்தைகள் மற்றும் பதில்களை நோக்கி வழிநடத்துவதில் முக்கிய பங்கு வகிக்கிறது. பணியில் உள்ள பணியின் நுணுக்கங்கள் மற்றும் குறிப்பிட்ட தேவைகளுக்கு ஏற்ப AI பொருந்துகிறது என்பதை உறுதிசெய்ய, பயிற்சியாளர்கள் டொமைன்-குறிப்பிட்ட தரவை கவனமாக தேர்ந்தெடுத்து வழங்க வேண்டும்.
வெகுமதி மாதிரி பயிற்சி
மூன்றாவது கட்டத்தில், AI உருவாக்கும் விரும்பத்தக்க வெளியீடுகளை அடையாளம் கண்டு வெகுமதி அளிக்க ஒரு தனி மாதிரியைப் பயிற்றுவிப்பீர்கள். இந்த படியானது கருத்து அடிப்படையிலான AI கற்றலுக்கு மையமானது.
வெகுமதி மாதிரியானது AI இன் வெளியீடுகளை மதிப்பிடுகிறது. இது பொருத்தம், துல்லியம் மற்றும் விரும்பிய முடிவுகளுடன் சீரமைப்பு போன்ற அளவுகோல்களின் அடிப்படையில் மதிப்பெண்களை வழங்குகிறது. இந்த மதிப்பெண்கள் பின்னூட்டமாக செயல்படுவதோடு உயர்தர பதில்களை உருவாக்க AIக்கு வழிகாட்டுகிறது. இந்த செயல்முறையானது சிக்கலான அல்லது அகநிலைப் பணிகளைப் பற்றிய நுணுக்கமான புரிதலை செயல்படுத்துகிறது.
ப்ராக்ஸிமல் பாலிசி ஆப்டிமைசேஷன் (பிபிஓ) வழியாக வலுவூட்டல் கற்றல்
அடுத்து, AI ஆனது ப்ராக்ஸிமல் பாலிசி ஆப்டிமைசேஷன் (PPO) வழியாக வலுவூட்டல் கற்றலுக்கு உட்படுகிறது, இது ஊடாடும் இயந்திர கற்றலில் ஒரு அதிநவீன வழிமுறை அணுகுமுறையாகும்.
PPO ஆனது AI ஐ அதன் சுற்றுச்சூழலுடனான நேரடி தொடர்புகளிலிருந்து கற்றுக்கொள்ள அனுமதிக்கிறது. இது வெகுமதிகள் மற்றும் அபராதங்கள் மூலம் அதன் முடிவெடுக்கும் செயல்முறையை செம்மைப்படுத்துகிறது. இந்த முறை நிகழ்நேர கற்றல் மற்றும் தழுவலில் குறிப்பாக பயனுள்ளதாக இருக்கும், ஏனெனில் இது பல்வேறு சூழ்நிலைகளில் அதன் செயல்களின் விளைவுகளைப் புரிந்துகொள்ள AI க்கு உதவுகிறது.
விரும்பிய முடிவுகள் உருவாகலாம் அல்லது வரையறுக்க கடினமாக இருக்கும் சிக்கலான, ஆற்றல்மிக்க சூழல்களுக்கு செல்ல AIக்கு கற்பிப்பதில் PPO கருவியாக உள்ளது.
சிவப்பு அணி
இறுதிக் கட்டத்தில், செயற்கை நுண்ணறிவு அமைப்பின் கடுமையான நிஜ உலகச் சோதனைகள் அடங்கும். இதில், ' சிவப்புக் குழு ' என்று அழைக்கப்படும் பல்வேறு மதிப்பீட்டாளர்கள் குழு, பலவிதமான சூழ்நிலைகளைக் கொண்டு அந்தச் செயற்கை நுண்ணறிவுக்கு சவால் விடுகிறது. துல்லியமாகவும் பொருத்தமாகவும் பதிலளிக்கும் அதன் திறனை அவர்கள் சோதிக்கிறார்கள். இந்தக் கட்டம், அந்தச் செயற்கை நுண்ணறிவால் நிஜ உலகப் பயன்பாடுகளையும் கணிக்க முடியாத சூழ்நிலைகளையும் கையாள முடியும் என்பதை உறுதி செய்கிறது.
ரெட் டீமிங் AI இன் தொழில்நுட்பத் திறன் மற்றும் நெறிமுறை மற்றும் சூழல்சார்ந்த தன்மையை சோதிக்கிறது. ஏற்றுக்கொள்ளக்கூடிய தார்மீக மற்றும் கலாச்சார எல்லைகளுக்குள் அது செயல்படுவதை அவர்கள் உறுதி செய்கிறார்கள்.
இந்தப் படிகள் முழுவதும், AI வளர்ச்சியின் ஒவ்வொரு கட்டத்திலும் மனித ஈடுபாட்டின் முக்கியத்துவத்தை RLHF வலியுறுத்துகிறது. கவனமாகத் தொகுக்கப்பட்ட தரவுகளுடன் ஆரம்பப் பயிற்சியை வழிநடத்துவது முதல் நுணுக்கமான பின்னூட்டம் மற்றும் கடுமையான நிஜ-உலகச் சோதனைகள் வரை, புத்திசாலித்தனமான, பொறுப்பான மற்றும் மனித மதிப்புகள் மற்றும் நெறிமுறைகளுக்கு இணங்கக்கூடிய AI அமைப்புகளை உருவாக்குவதற்கு மனித உள்ளீடு ஒருங்கிணைந்ததாகும்.
தீர்மானம்
மனித பின்னூட்டத்துடன் கூடிய வலுவூட்டல் கற்றல் (RLHF) AI இல் ஒரு புதிய சகாப்தத்தைக் காட்டுகிறது, ஏனெனில் இது மனித நுண்ணறிவுகளை இயந்திரக் கற்றலுடன் மேலும் நெறிமுறை, துல்லியமான AI அமைப்புகளுக்கு ஒருங்கிணைக்கிறது.
RLHF, AI ஐ மேலும் பச்சாதாபமானதாகவும், உள்ளடக்கியதாகவும், புதுமையானதாகவும் மாற்றுவதாக உறுதியளிக்கிறது. இது சார்புகளை நிவர்த்தி செய்யலாம் மற்றும் சிக்கலைத் தீர்ப்பதை மேம்படுத்தலாம். இது சுகாதாரம், கல்வி மற்றும் வாடிக்கையாளர் சேவை போன்ற துறைகளை மாற்றும் வகையில் அமைக்கப்பட்டுள்ளது.
இருப்பினும், இந்த அணுகுமுறையை செம்மைப்படுத்துவதற்கு செயல்திறன், நேர்மை மற்றும் நெறிமுறை சீரமைப்பு ஆகியவற்றை உறுதி செய்வதற்கான தொடர்ச்சியான முயற்சிகள் தேவை.