
நிறுவன செயற்கை நுண்ணறிவின் மையத்தில் ஒரு நுட்பமான முரண் உள்ளது: உங்கள் தரவுகள் ஸ்கேன் செய்யப்பட்ட விலைப்பட்டியல், தொலைநகல் செய்யப்பட்ட ஆய்வக அறிக்கை அல்லது கையால் எழுதப்பட்ட விநியோகக் குறிப்பு போன்றவற்றில் சிக்கியிருந்தால், உலகின் மிகச் சிறந்த மாதிரிகளால் கூட உங்களுக்கு உதவ முடியாது. மேலும், மதிப்பிடப்பட்ட 80% வணிகத் தரவுகள், சரியாக இதுபோன்ற கட்டமைக்கப்படாத ஆவணங்களில்தான் உள்ளன.
ஒளியியல் எழுத்துணரி (Optical Character Recognition) — OCR — என்பது அந்தத் தரவுகளை விடுவிக்கும் ஒரு தொழில்நுட்பமாகும். மேலும், 2026-ல் இது ஒரு முக்கிய இடத்தைப் பிடித்துள்ளது. உலகளாவிய OCR சந்தையானது, 2023-ல் $13.1 பில்லியனாக இருந்தது. இது ஆண்டுக்கு 15.5% என்ற வளர்ச்சி விகிதத்தில், 2033-க்குள் $55.3 பில்லியனை எட்டும் என்று கணிக்கப்பட்டுள்ளது. நவீன என்ஜின்கள் பக்க அளவில் வழக்கமாக 98–99% துல்லியத்தை அடைகின்றன. ஒரு காலத்தில் சிக்கலான ஸ்கேனிங் பயன்பாடாக இருந்த இது, இன்று நிறுவன தன்னியக்கத்திற்கான (corporate automation) நுழைவாயிலாக மாறியுள்ளது.
OCR இன்று எப்படி இருக்கிறது: அது எவ்வாறு செயல்படுகிறது, தற்போதுள்ள வகைகள், செயற்கை நுண்ணறிவு என்ன மாற்றங்களைக் கொண்டு வந்துள்ளது, மற்றும் அதன் எதிர்காலத் திசை ஆகியவை இங்கே கொடுக்கப்பட்டுள்ளன.
OCR என்றால் என்ன?
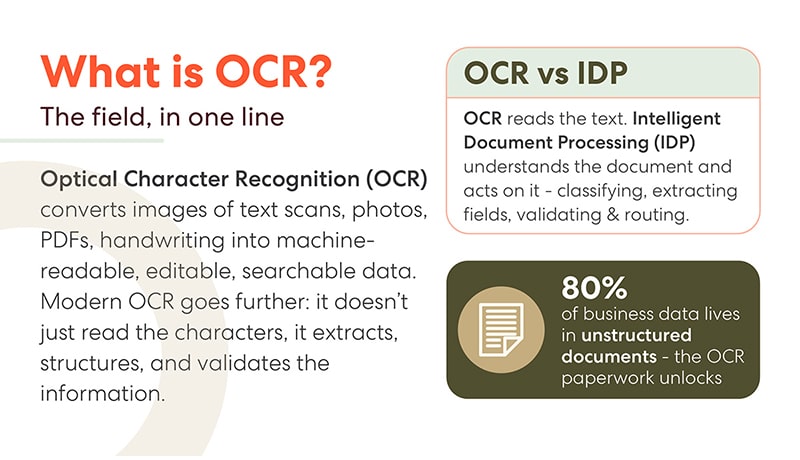
ஒளியியல் எழுத்துணரி (Optical Character Recognition) என்பது, ஸ்கேன்கள், புகைப்படங்கள், PDF-கள், கையெழுத்து போன்ற உரை வடிவங்களை, கணினியால் படிக்கக்கூடிய, திருத்தக்கூடிய, தேடக்கூடிய தரவுகளாக மாற்றுகிறது. இது பாடப்புத்தகத்தில் உள்ள வரையறை, ஆனால் 2026-ல் உண்மையில் என்ன நடக்கிறது என்பதை இது குறைத்து மதிப்பிடுகிறது.
நவீன OCR வெறும் எழுத்துக்களை மட்டும் படிப்பதில்லை. அது புலங்கள், அட்டவணைகள், வரி உருப்படிகள் போன்ற கட்டமைப்புகளைப் பிரித்தெடுத்து, தான் பெறும் தகவல்களைச் சரிபார்க்கிறது. கைப்பேசியில் புகைப்படம் எடுக்கப்பட்ட, கசங்கிய ஒரு விலைப்பட்டியலை அதற்கு உள்ளீடாகக் கொடுத்தால், அது வெறும் உரைத் திரளைத் தராமல், விற்பனையாளர், தேதி, வரி உருப்படிகள், மொத்தம் என ஒவ்வொன்றுக்கும் ஒரு நம்பகத்தன்மை மதிப்பெண்ணுடன் கூடிய ஒரு கட்டமைக்கப்பட்ட பதிவைத் தரும்.
OCR மற்றும் IDP: ஒரு முக்கியமான வேறுபாடு
ஒவ்வொரு விற்பனையாளர் உரையாடலிலும் இந்த இரண்டு சொற்களையும் நீங்கள் கேட்பீர்கள், எனவே இதோ அவற்றின் வேறுபாடு. OCR உரையைப் படிக்கிறது. நுண்ணறிவு ஆவணச் செயலாக்கம் (IDP) ஆவணத்தைப் புரிந்துகொண்டு அதற்கேற்ப செயல்படுகிறது — அதாவது, அது என்ன வகையான ஆவணம் என வகைப்படுத்துதல், முக்கியமான புலங்களைப் பிரித்தெடுத்தல், வணிக விதிகளுடன் அவற்றைச் சரிபார்த்தல், மற்றும் முடிவைச் சரியான அமைப்புக்கு அனுப்புதல்.
OCR-ஐக் கண்களாகவும், IDP-ஐ மூளையாகவும் கருதுங்கள். ஒன்று இல்லாமல் மற்றொன்று உங்களை பாதி வழியில் மட்டுமே கொண்டு செல்லும்: ஒன்று, கச்சிதமாகப் படியெடுக்கப்பட்ட உரைக்கு மனிதர் விளக்கம் தேவைப்படும்; அல்லது, படிக்கக்கூடிய உள்ளீடுகள் இல்லாமல் தவிக்கும் ஒரு திறன்மிகு பணிப்பாய்வு. சந்தை உறுதியாக இந்த இரண்டின் கலவையை நோக்கியே நகர்கிறது.
OCR செயல்படும் விதம்: நவீன 6-படி செயல்முறை
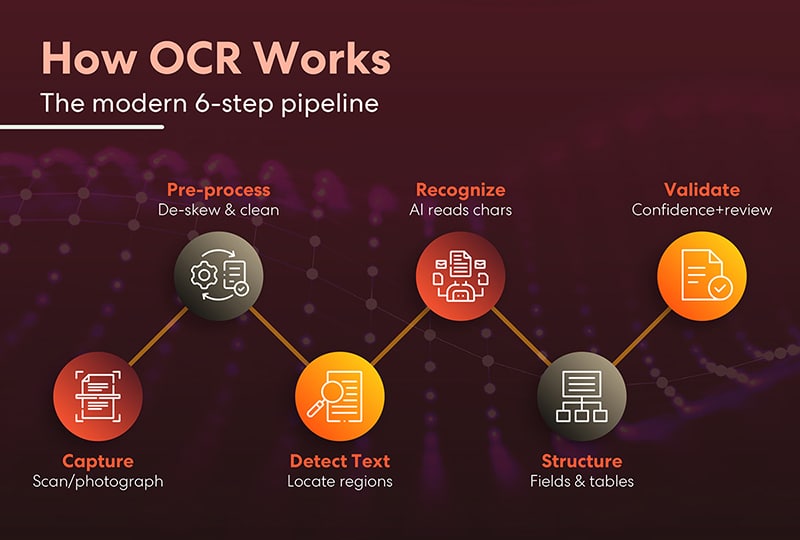
இன்றைய OCR அமைப்புகள் ஆறு-படிநிலை செயல்முறையைப் பின்பற்றுகின்றன, மேலும் அதைப்புரிந்துகொள்வது, துல்லியம் ஏன் பெருமளவில் உயர்ந்துள்ளது என்பதையும், பிழைகள் இன்னும் எங்கே நுழைகின்றன என்பதையும் விளக்க உதவுகிறது.
இது ஆவணத்தை ஸ்கேன் அல்லது புகைப்படம் எடுப்பதன் மூலம் தொடங்குகிறது. பின்னர் , முன் செயலாக்கம் படத்தை சுத்தப்படுத்துகிறது: சாய்ந்த பக்கங்களைச் சரிசெய்தல், இரைச்சலை நீக்குதல் மற்றும் மாறுபாட்டைச் சரிசெய்தல் போன்றவற்றைச் செய்கிறது, ஏனெனில் அங்கீகாரத்தின் தரம் அது தொடங்கும் படத்தின் தரத்தைப் பொறுத்தே அமைகிறது. அடுத்து, உரை கண்டறிதல் பக்கத்தில் உண்மையில் உரையைக் கொண்டிருக்கும் பகுதிகளைக் கண்டறிந்து, வார்த்தைகளை சின்னங்கள், முத்திரைகள் மற்றும் பின்னணியிலிருந்து பிரிக்கிறது. பின்னர் அங்கீகாரம் வருகிறது , அங்கு செயற்கை நுண்ணறிவு எழுத்துக்களைப் படிக்கிறது — இந்த படிநிலையைத்தான் பெரும்பாலான மக்கள் "OCR" என்று நினைக்கிறார்கள். ஆனால் நவீன செயல்முறை அத்துடன் நின்றுவிடுவதில்லை. கட்டமைத்தல் மூல உரையை புலங்கள் மற்றும் அட்டவணைகளாக வரைபடமாக்கி, "ஒரு பக்கத்தில் உள்ள வார்த்தைகளை" "ஒரு திட்டத்தில் உள்ள தரவாக" மாற்றுகிறது. இறுதியாக, சரிபார்ப்பு நம்பகத்தன்மை மதிப்பெண் மற்றும் மதிப்பாய்வைப் பயன்படுத்துகிறது, உங்கள் அமைப்புகளுக்குள் நுழைவதற்கு முன்பு மனிதர்களுக்குத் தெரியாத எதையும் கொடியிடுகிறது.
படம் பிடித்தல் → முன் செயலாக்கம் → கண்டறிதல் → அடையாளம் காணுதல் → கட்டமைத்தல் → சரிபார்த்தல். இந்தக் கடைசி இரண்டு படிகள்தான், ஒரு தசாப்தத்திற்கு முந்தைய ஸ்கேனிங் மென்பொருளிலிருந்து 2026-ஆம் ஆண்டு காலத்திய OCR-ஐ வேறுபடுத்துகின்றன.
OCR வகைகள்: எல்லா அங்கீகாரமும் ஒரே மாதிரியானதல்ல
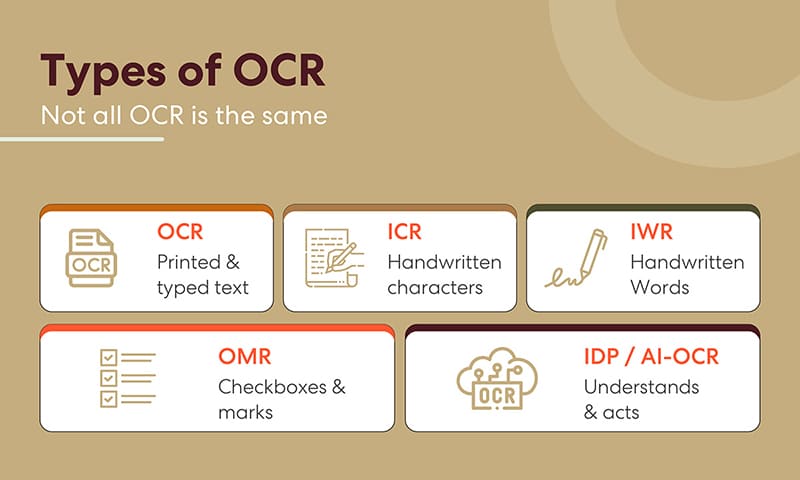
"OCR" என்பது ஒரு பொதுவான சொல்லாகப் பயன்படுத்தப்பட்டாலும், இத்துறை வெவ்வேறு உள்ளடக்கங்களுக்கு ஏற்ற பல தொழில்நுட்பங்களை வேறுபடுத்துகிறது.
OCR என்பது அச்சிடப்பட்ட மற்றும் தட்டச்சு செய்யப்பட்ட உரையை கையாளுகிறது — இதுவே மிகவும் எளிதான மற்றும் முதிர்ச்சியடைந்த தொழில்நுட்பமாகும். ICR (அறிவார்ந்த எழுத்து அறிதல்) என்பது கையால் எழுதப்பட்ட எழுத்துக்களைப் படிக்கிறது, இது இத்துறையில் உள்ள மிகவும் கடினமான சவால்களில் ஒன்றாகும். IWR (அறிவார்ந்த சொல் அறிதல்) ஒரு படி மேலே சென்று, தனித்தனி எழுத்துக்களைக் காட்டிலும் முழுமையான கையெழுத்துச் சொற்களையும் அடையாளம் காண்கிறது — இது எழுத்துக்கள் ஒன்றோடொன்று கலந்து மங்கலாகத் தெரியும் சாய்வெழுத்துக்களுக்கு மிகவும் பொருத்தமானது. OMR (ஒளியியல் குறியீடு அறிதல்) என்பது சரிபார்ப்புப் பெட்டிகளையும் குறியீடுகளையும் படிக்கிறது; இதுவே படிவங்கள் மற்றும் விடைத்தாள்களுக்குப் பின்னால் உள்ள தொழில்நுட்பமாகும். மேலும், IDP / AI-OCR இந்த வரிசையில் உச்சத்தில் உள்ளது: இவை வெறும் எழுத்துக்களைப் படிப்பது மட்டுமல்லாமல், புரிந்துகொண்டு செயல்படும் அமைப்புகளாகும்.
உங்கள் ஆவணங்களுக்கு எந்த வகை தேவை என்பதை அறிவதுதான் எந்தவொரு OCR திட்டத்தின் முதல் கேள்வியாகும். அச்சிடப்பட்ட விலைப்பட்டியலும், மருத்துவரின் கையெழுத்து மருந்துச் சீட்டும் முற்றிலும் வெவ்வேறான சிக்கல்களாகும்.
செயற்கை நுண்ணறிவு யுகத்தில் OCR: ரா OCR என்பது இப்போது வெறும் முதல் படிதான்
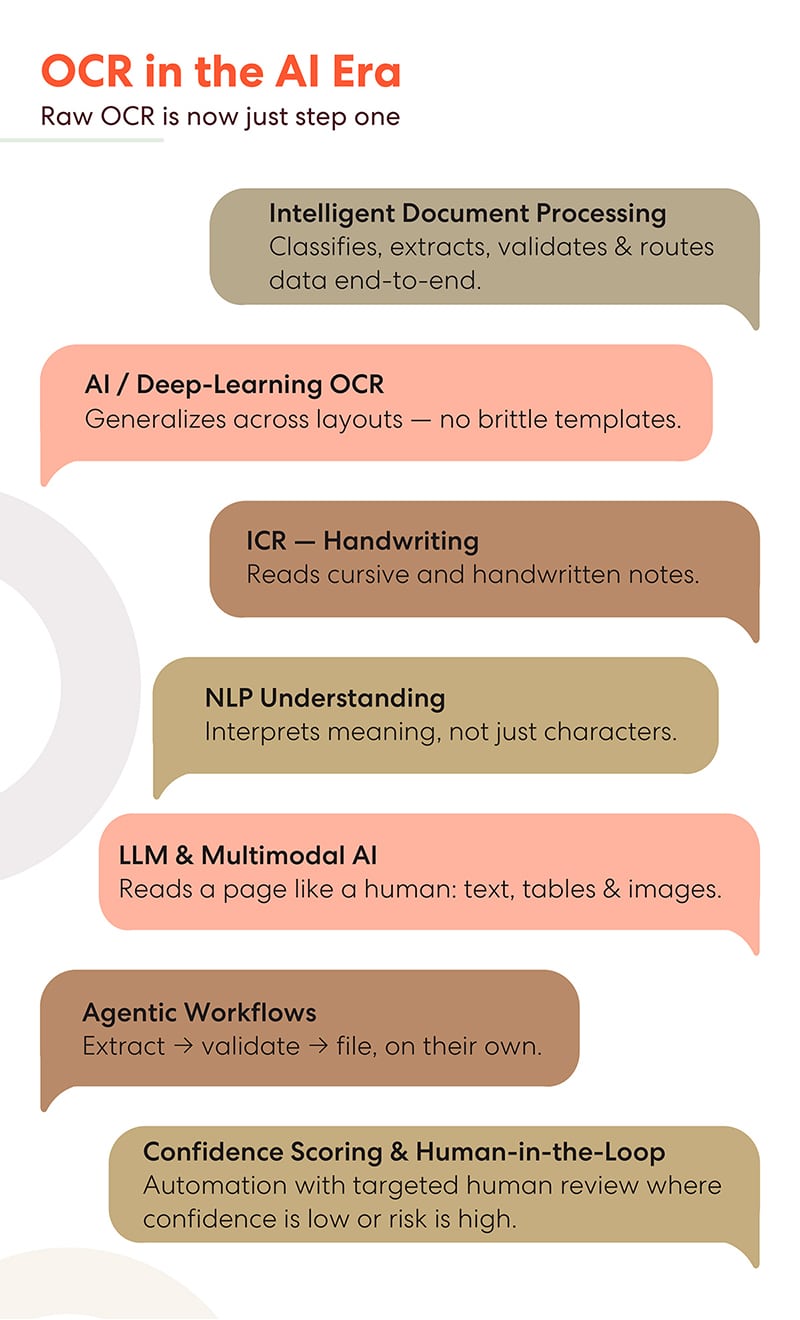
இத்துறையில் ஏற்பட்டுள்ள மிக ஆழமான மாற்றம் என்னவென்றால், ஒரு காலத்தில் முழுமையான தயாரிப்பாக இருந்த எழுத்து அறிதல் திறன், இப்போது வெறும் நுழைவாயிலாக மட்டுமே உள்ளது. நவீன ஆவணச் செயற்கை நுண்ணறிவை ஏழு திறன்கள் வரையறுக்கின்றன.
அறிவார்ந்த ஆவணச் செயலாக்கம் , ஆவணங்களை வகைப்படுத்துதல், புலங்களைப் பிரித்தெடுத்தல், தரவைச் சரிபார்த்தல் மற்றும் முடிவுகளைக் கைமுறைப் பரிமாற்றங்கள் இன்றி வழிப்படுத்துதல் என முழு செயல்முறையையும் தொடக்கத்திலிருந்து இறுதிவரை இயக்குகிறது.
செயற்கை நுண்ணறிவு மற்றும் ஆழ் கற்றல் மூலமான OCR, பல்வேறு தளவமைப்புகளிலும் தனது செயல்பாட்டைப் பொதுமைப்படுத்துகிறது. பழைய அமைப்புகளுக்கு ஒவ்வொரு ஆவண வடிவத்திற்கும் எளிதில் மாறக்கூடிய ஒரு வார்ப்புரு தேவைப்பட்டது; ஆனால் நவீன மாதிரிகள், பொதுவாக விலைப்பட்டியல்கள் எப்படி இருக்கும் என்பதைக் கற்றுக்கொண்டதால், அவை இதற்கு முன் பார்த்திராத ஒரு விலைப்பட்டியலைக் கூட கையாளுகின்றன.
ஐசிஆர் கையெழுத்து அறிதல் தொழில்நுட்பமானது, சாய்வெழுத்து மற்றும் கையால் எழுதப்பட்ட குறிப்புகளைப் படிக்கும் அளவிற்கு முதிர்ச்சியடைந்துள்ளது. இதன் மூலம், முன்பு அணுக முடியாத மருத்துவப் பதிவுகள், பிரசவச் சீட்டுகள் மற்றும் காப்பக ஆவணங்கள் போன்றவற்றை இப்போது அணுக முடிகிறது.
NLP புரிதல் என்பது வெறும் எழுத்துக்களை மட்டுமல்ல, அதன் அர்த்தத்தையும் விளக்குகிறது. இந்த அமைப்பு “Net 30” என்பதை வெறுமனே படியெடுப்பதில்லை — அது ஒரு கட்டண விதிமுறை என்பதை அது அறிந்திருக்கிறது.
LLM-களும் பன்முக AI-யும், ஒரு மனிதன் ஒரு பக்கத்தைப் படிப்பதைப் போலவே படிக்கின்றன: உரை, அட்டவணைகள் மற்றும் படங்கள் ஆகியவற்றைச் சூழலுக்கு ஏற்ப ஒன்றாகப் படிக்கின்றன. இது இந்த அடுக்கு அமைப்பின் புதிய மற்றும் அதிவேகமாக வளர்ந்து வரும் அடுக்கு ஆகும்.
முகவர் சார்ந்த பணிப்பாய்வுகள் , பிரித்தெடுத்தல் → சரிபார்த்தல் → கோப்பிடுதல் எனத் தன்னிச்சையாகச் சுழற்சியை நிறைவு செய்கின்றன. ஆவணம் வெறுமனே படிக்கப்படுவதில்லை; அது கையாளப்படுகிறது.
மனித ஈடுபாட்டுடன் கூடிய நம்பகத்தன்மை மதிப்பீட்டு முறையானது, இவை அனைத்தையும் பாதுகாப்பாகச் செயல்படுத்த உதவுகிறது. நம்பகத்தன்மை அதிகமாக இருக்கும் இடங்களில் தானியக்கம் தொடர்கிறது; நம்பகத்தன்மை குறைவாகவோ அல்லது இடர் அதிகமாகவோ இருக்கும் இடங்களில் மட்டுமே மனிதர்கள் மதிப்பாய்வு செய்கிறார்கள். இந்த இலக்கு சார்ந்த மதிப்பாய்வு மாதிரியின் மூலம்தான் நிறுவனங்கள் வேகத்தையும் தணிக்கைத் திறனையும் பெறுகின்றன.
OCR பயன்பாட்டு நேர்வுகள்: அது மதிப்பு வழங்கும் இடங்கள்
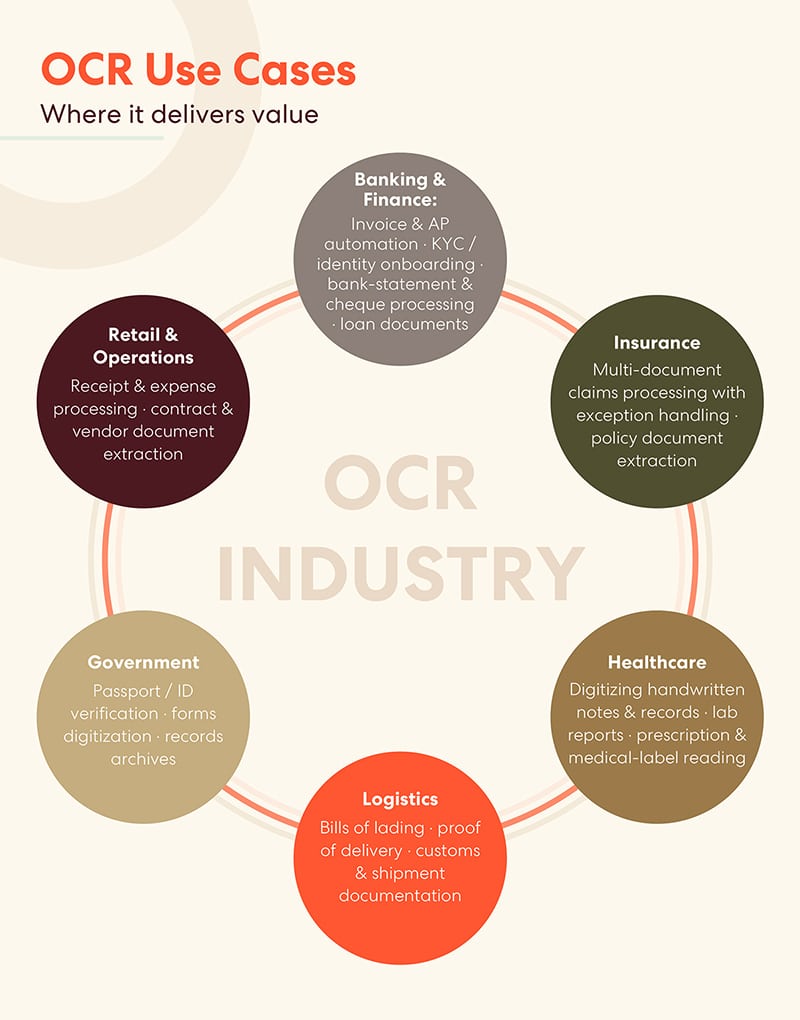
காகிதப் பணிகளில் மூழ்கித் தவிக்கும் தொழில்துறைகளே OCR-ஐ மிக வேகமாக ஏற்றுக்கொள்கின்றன.
வங்கி மற்றும் நிதித் துறை சந்தையில் முன்னணியில் உள்ளது — விலைப்பட்டியல் மற்றும் AP தானியக்கம், KYC மற்றும் அடையாளப் பதிவு, வங்கி அறிக்கை மற்றும் காசோலை செயலாக்கம். BFSI துறை சந்தையில் சுமார் 21% பங்கைக் கொண்டு, மிகப்பெரிய OCR பிரிவாக இருப்பது தற்செயலானது அல்ல. காப்பீட்டுத் துறை, விதிவிலக்கு கையாளுதல் மற்றும் பாலிசி ஆவணப் பிரித்தெடுத்தலுடன் கூடிய பல-ஆவணக் கோரிக்கை செயலாக்கத்திற்கு இதைப் பயன்படுத்துகிறது — ஒரு கோரிக்கையில் பல்வேறு வடிவங்களில் டஜன் கணக்கான ஆவணங்கள் இருக்கலாம். சுகாதாரத் துறையில் , OCR கையால் எழுதப்பட்ட குறிப்புகள் மற்றும் பதிவுகளை டிஜிட்டல் மயமாக்குகிறது, ஆய்வக அறிக்கைகளைப் படிக்கிறது, மேலும் மருந்துச் சீட்டுகள் மற்றும் மருத்துவ லேபிள்களைச் செயலாக்குகிறது, இங்கு துல்லியம் என்பது உண்மையில் ஒரு பாதுகாப்புப் பிரச்சினையாகும். சரக்குப் போக்குவரத்து ஆவணங்களைச் சார்ந்து இயங்குகிறது — சரக்குச் சீட்டுகள், விநியோகச் சான்று, சுங்க மற்றும் ஏற்றுமதி ஆவணங்கள் — மேலும் OCR, ஆவணங்கள் ஒரு தடையாக மாறுவதைத் தடுப்பதன் மூலம் சரக்குகள் தொடர்ந்து நகர்வதை உறுதி செய்கிறது. அரசாங்கம் இதை கடவுச்சீட்டு மற்றும் அடையாள சரிபார்ப்பு, படிவச் செயலாக்கம் மற்றும் பதிவுக் காப்பகங்களை டிஜிட்டல் மயமாக்குவதற்குப் பயன்படுத்துகிறது. மேலும் சில்லறை விற்பனை மற்றும் செயல்பாடுகளில் , இது ரசீது மற்றும் செலவு செயலாக்கம் மற்றும் ஒப்பந்தம் மற்றும் விற்பனையாளர் ஆவணப் பிரித்தெடுத்தலுக்கு ஆற்றல் அளிக்கிறது.
இந்த ஆறு முறைகளிலும் காணப்படும் பொதுவான அம்சம் இதுதான்: முன்பு மனிதர்கள் காகிதத்தில் இருந்து தகவல்களை ஒரு கணினி அமைப்பில் தட்டச்சு செய்து வந்த இடங்களில் எல்லாம், இப்போது OCR அதனை வேகமாகவும், மலிவாகவும், ஒரு தணிக்கைப் பதிவுடனும் செய்கிறது.
நன்மைகளும் சவால்களும்: ஒரு உண்மையான சித்திரம்
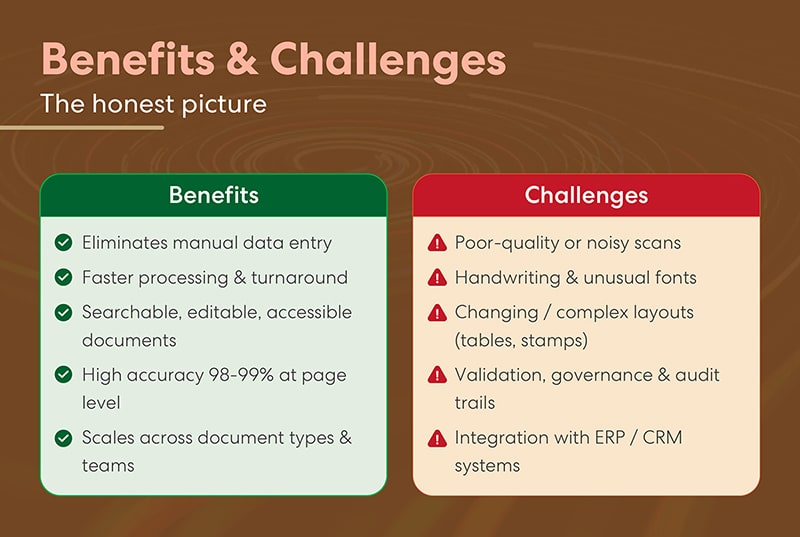
நன்மைகள் உறுதியானவை. OCR, எந்தவொரு அலுவலகப் பணியிலும் மிகவும் பிழை ஏற்படக்கூடியதும், மிகக் குறைவாக விரும்பப்படுவதுமான கைமுறை தரவு உள்ளீட்டை நீக்குகிறது. செயலாக்கமும், பணிகளை முடித்துத் தரும் வேகமும் வியத்தகு அளவில் அதிகரிக்கின்றன. ஆவணங்கள் பயனற்ற ஸ்கேன்களாக இல்லாமல், தேடக்கூடியதாகவும், திருத்தக்கூடியதாகவும், அணுகக்கூடியதாகவும் மாறுகின்றன. பக்க அளவில் துல்லியம் இப்போது 98–99% ஐ எட்டுகிறது. மேலும், நவீன அமைப்புகள் அறிமுகமில்லாத ஆவணங்களில் திணறுவதற்குப் பதிலாக, பல்வேறு ஆவண வகைகள் மற்றும் வடிவங்களுக்கு ஏற்ப விரிவடையும் திறன் கொண்டவை.
ஆனால், உண்மையான செயல்பாடுகள் இன்னமும் உண்மையான சிக்கல்களை எதிர்கொள்கின்றன. தரம் குறைந்த அல்லது இரைச்சல் மிகுந்த ஸ்கேன்களே துல்லியத்தைக் குறைக்கும் முதன்மைக் காரணியாக இருக்கின்றன — தெளிவாகப் படிக்க முடியாததை எந்த மாடலும் படிப்பதில்லை. கையெழுத்தும் வழக்கத்திற்கு மாறான எழுத்துருக்களும் அச்சிடப்பட்ட உரையை விட பின்தங்கியே இருக்கின்றன. மாறிக்கொண்டே இருக்கும் மற்றும் சிக்கலான தளவமைப்புகள் — உள்ளமைக்கப்பட்ட அட்டவணைகள், முத்திரைகள், பல-பத்தி படிவங்கள் — தரவுப் பிரித்தெடுப்பைத் தடுக்கின்றன. சரிபார்ப்பு, நிர்வாகம் மற்றும் தணிக்கைப் பதிவுகளுக்கு, குறிப்பாக ஒழுங்குபடுத்தப்பட்ட தொழில்களில், உண்மையான பொறியியல் முயற்சி தேவைப்படுகிறது. மேலும், ERP மற்றும் CRM அமைப்புகளுடனான ஒருங்கிணைப்பில்தான் பல திட்டங்கள் தடைபடுகின்றன: உண்மையில் வேலை நடக்கும் இடத்தில் தரவு சென்றடையும்போது மட்டுமே, அதிலிருந்து தரவைப் பிரித்தெடுப்பது பயனுள்ளதாக இருக்கும்.
இவை எதுவும் முடிவை மாற்றிவிடும் காரணிகள் அல்ல. நம்பகத்தன்மை மதிப்பெண் மற்றும் மனித ஈடுபாட்டுடன் கூடிய மதிப்பாய்வு ஆகியவை இருப்பதற்கும், மாதிரித் தேர்வைப் போலவே ஆவணத்தின் தரம் மற்றும் நன்கு விளக்கமளிக்கப்பட்ட பயிற்சித் தரவுகளும் முக்கியத்துவம் பெறுவதற்கும் இவைதான் காரணம்.
OCR சந்தை: பெறப்பட்ட மற்றும் தற்போதைய
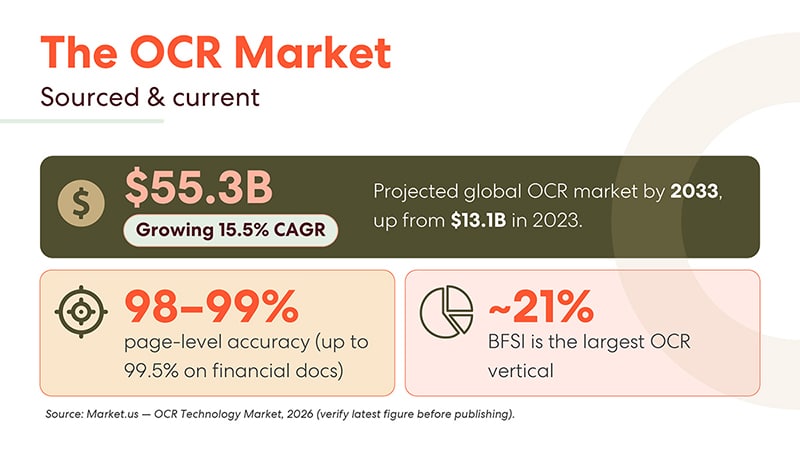
புள்ளிவிவரங்கள் இந்த வாய்ப்பை எடுத்துக்காட்டுகின்றன. உலகளாவிய OCR சந்தை 2023-ல் $13.1 பில்லியனிலிருந்து, 2033-க்குள் $55.3 பில்லியனை எட்டும் என்று கணிக்கப்பட்டுள்ளது — இது 15.5% கூட்டு வருடாந்திர வளர்ச்சி விகிதமாகும் . பக்க அளவிலான துல்லியம் 98–99%-ஐ எட்டியுள்ளது , மேலும் நிதி ஆவணங்களில் இது இன்னும் அதிகமாக உயர்ந்து வருகிறது. மேலும், சந்தையில் சுமார் 21% பங்கைக் கொண்டு BFSI மிகப்பெரிய பிரிவாக உள்ளது , இது முதலீட்டின் மீதான வருவாய் (ROI) முதலில் எங்கு நிரூபிக்கப்படுகிறது என்பதற்கான ஒரு அறிகுறியாகும்.
அடுத்து என்ன: 2026-ஆம் ஆண்டுக்கான OCR போக்குகள்
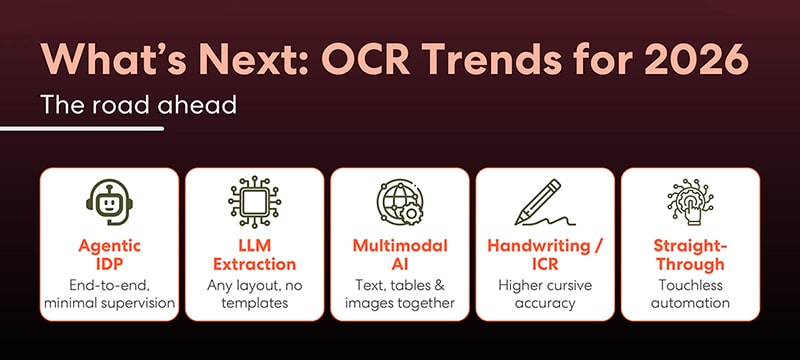
ஐந்து போக்குகள் எதிர்காலப் பாதையை வரையறுக்கின்றன. முகவர் வழி IDP — மனிதத் தலையீடு இன்றி, முழுமையாக இயங்கும் ஆவணப் பணிப்பாய்வுகள். LLM-ஆற்றல் பெற்ற பிரித்தெடுத்தல் — பெரிய மொழி மாதிரிகளைப் பயன்படுத்தி, சிறிய அல்லது வார்ப்புரு அமைப்பு இல்லாமலேயே ஆவணங்களிலிருந்து கட்டமைக்கப்பட்ட தரவைப் பிரித்தெடுத்தல். பன்முறைமை செயற்கை நுண்ணறிவு — உரை, அட்டவணைகள் மற்றும் படங்களை ஒரே முறையில் செயலாக்கி, ஆவணங்களைத் துண்டுகளாகப் பார்க்காமல் முழுமையாகப் புரிந்துகொள்ளும் மாதிரிகள். கையெழுத்து மற்றும் ICR முன்னேற்றங்கள் — வளைந்த மற்றும் கோணலான கையெழுத்துகளில் சீராக அதிகரித்து வரும் துல்லியம், முன்பு கைமுறையாக மட்டுமே கையாளப்பட்ட ஆவண வகைகளைத் திறக்கிறது. மற்றும் நேரடிச் செயலாக்கம் — இதன் இறுதி இலக்கு: ஆவணங்கள் வந்து, படிக்கப்பட்டு, சரிபார்க்கப்பட்டு, மனிதத் தலையீடு இன்றி கோப்பில் இடப்படுதல்.
திசை தெளிவானது: ஆவணங்களைப் படிப்பதிலிருந்து அவற்றைக் கையாளுவது வரை.
அடிக்கோடு
2026-ல் OCR என்பது இனி படங்களை உரையாக மாற்றுவது அல்ல — அது காகித ஆவணங்களை முழுமையான பணிகளாக மாற்றுவதாகும். 80% வணிகத் தரவுகள் கட்டமைக்கப்படாத ஆவணங்களில் முடங்கிக் கிடப்பதாலும், சந்தை 55 பில்லியன் டாலர்களை நோக்கி உயர்ந்து வருவதாலும், பெரும்பாலான நிறுவனங்களுக்கு எழும் கேள்வி, OCR-ஐப் பயன்படுத்துவதா வேண்டாமா என்பதல்ல; மாறாக, படிநிலையின் எந்த நிலைக்குச் செல்வது என்பதேயாகும்: அதாவது, சாதாரண உரை பிரித்தெடுத்தல், கட்டமைக்கப்பட்ட IDP, அல்லது முழுமையான முகவர் சார்ந்த ஆவணப் பணிப்பாய்வுகள்.
ஆவணங்கள் ஏற்கனவே குவிந்து வருகின்றன. அவற்றை வாசிப்பதற்கும், அவற்றின் மீது நடவடிக்கை எடுப்பதற்குமான தொழில்நுட்பம் தயாராக உள்ளது.