ஒளியியல் எழுத்து அறிதல் (OCR) இப்போது ரசீது ஸ்கேனிங், அடையாள சரிபார்ப்பு, விலைப்பட்டியல் தானியக்கம், வரலாற்று ஆவணக்காப்பக டிஜிட்டல்மயமாக்கல் மற்றும் ஸ்டைலஸ் அடிப்படையிலான குறிப்புச் செயலிகளை இயக்குகிறது. OCR சந்தை 2030-க்குள் 14.8% கூட்டு வருடாந்திர வளர்ச்சி விகிதத்தில் (CAGR) $32.90 பில்லியனை எட்டும் என்று கணிக்கப்பட்டுள்ளது (கிராண்ட் வியூ ரிசர்ச், 2024). இதில், OCR-இன் கையெழுத்து-வாசிப்புப் பிரிவான அறிவார்ந்த எழுத்து அறிதல் மிக வேகமாக வளர்ந்து வருகிறது. நீங்கள் ஆவணப் பகுப்பாய்வு, காட்சி-உரை கண்டறிதல் அல்லது கையெழுத்து படியெடுத்தல் போன்றவற்றை உருவாக்கினாலும், நீங்கள் பயிற்சி அளிக்கும் OCR தரவுத்தொகுப்பே உங்கள் துல்லியத்தின் உச்சவரம்பை நிர்ணயிக்கிறது. இந்த வழிகாட்டி, பயன்பாட்டு வகைகளின் அடிப்படையில் ஒழுங்கமைக்கப்பட்ட மற்றும் 2024 வரையிலான வலிமையான வெளியீடுகளுடன் புதுப்பிக்கப்பட்ட 22 இலவச, திறந்த மூல OCR தரவுத்தொகுப்புகளை — சிறந்த கையெழுத்துத் தரவுத்தொகுப்புகள் உட்பட — உள்ளடக்கியுள்ளது.
முக்கிய எடுத்துக்காட்டுகள்
- OCR (ஒளியியல் எழுத்து அறிதல்): அச்சிடப்பட்ட, காட்சி அல்லது கையெழுத்து உரையின் படங்களை இயந்திரம் படிக்கக்கூடிய தரவுகளாக மாற்றும் தொழில்நுட்பம்.
- OCR தரவுத்தொகுப்புகள் ஆவணம்/படிவம், காட்சி உரை, இலக்கம்/எழுத்து, கையெழுத்து மற்றும் பன்மொழி என ஐந்து குழுக்களாகப் பிரிக்கப்பட்டுள்ளன.
- ஆவண OCR தரவுத்தொகுப்புகள் படிவங்கள் மற்றும் ரசீதுகள் போன்ற கட்டமைக்கப்பட்ட பக்கங்களைப் படம்பிடிக்கவும்; காட்சி-உரை தரவுத்தொகுப்புகள் இயல்பான சூழலில் உரையைப் பதிவு செய்யவும்.
- IAM, MNIST, ICDAR மற்றும் SROIE ஆகியவை ஆய்வுகள் முழுவதும் அதிகம் மேற்கோள் காட்டப்படும் OCR அளவுகோல்களாகத் திகழ்கின்றன.
- உரிம விதிமுறைகள் பரவலாக வேறுபடுகின்றன — வணிகப் பயிற்சிக்கு முன் ஒவ்வொரு OCR தரவுத்தொகுப்பையும் சரிபார்க்கவும்.
OCR (ஆப்டிகல் கேரக்டர் ரெகக்னிஷன்) என்றால் என்ன?
OCR என்பது ஸ்கேன் செய்யப்பட்ட காகித ஆவணங்கள், PDFகள் அல்லது உரையின் படங்கள் போன்ற பல்வேறு வகையான ஆவணங்களை திருத்தக்கூடிய மற்றும் தேடக்கூடிய தரவுகளாக மாற்றும் தொழில்நுட்பமாகும். இது வேலை செய்கிறது:
- ஒரு படத்தில் உள்ள உரையின் கட்டமைப்பை பகுப்பாய்வு செய்தல்
- உரையை வரிகளாகவும் எழுத்துக்களாகவும் உடைத்தல்
- இந்த காட்சி எழுத்துக்களை இயந்திரம் படிக்கக்கூடிய உரையாக மாற்றுகிறது
பொதுவான பயன்பாடுகள் பின்வருமாறு:
- ஸ்கேன் செய்யப்பட்ட ஆவணங்களை திருத்தக்கூடிய உரை கோப்புகளாக மாற்றுகிறது
- அச்சிடப்பட்ட புத்தகங்களை டிஜிட்டல் மயமாக்குதல்
- படங்களிலிருந்து உரையைப் பிரித்தெடுத்தல்
- கையால் எழுதப்பட்ட மருந்துச்சீட்டுகளை டிஜிட்டல் உரையாக மாற்றுதல்
- உரிமத் தட்டு அங்கீகாரம்
சரியான OCR தரவுத்தொகுப்பை எவ்வாறு தேர்ந்தெடுப்பது?
ஒரு OCR தரவுத்தொகுப்பைத் தேர்ந்தெடுப்பது நான்கு காரணிகளைச் சார்ந்துள்ளது: உரை வகை, பதிவுசெய்யும் சூழல், குறிப்புரையின் நுணுக்கம் மற்றும் உரிமம். அச்சிடப்பட்ட ஆவண OCR-க்கு, கையால் எழுதப்பட்ட வளைந்த அல்லது வளைவான காட்சி உரையை விட வேறுபட்ட பயிற்சித் தரவுகள் தேவைப்படுகின்றன. ஆவணத் தரவுத்தொகுப்புகள் விலைப்பட்டியல்கள், படிவங்கள் மற்றும் ரசீதுகளுக்குப் பொருத்தமானவை; காட்சி-உரைத் தரவுத்தொகுப்புகள் அடையாளப் பலகைகள் மற்றும் தயாரிப்பு வாசிப்பிற்குப் பொருத்தமானவை; கையெழுத்துத் தரவுத்தொகுப்புகள் குறிப்புகள், கையெழுத்துப் பிரதிகள் மற்றும் எழுத்தாணி உள்ளீட்டிற்குப் பொருத்தமானவை. சொல்-நிலை மற்றும் வரி-நிலை குறிப்புரைகள் முழுமையான OCR செயல்முறைகளை ஆதரிக்கின்றன, அதே சமயம் எழுத்து-நிலைத் தொகுப்புகள் வகைப்பாட்டு அடிப்படைகளுக்குப் பொருந்துகின்றன. உரிம விதிமுறைகளை எப்போதும் உறுதிப்படுத்திக்கொள்ளுங்கள், ஏனெனில் சில OCR தரவுத்தொகுப்புகள் ஆராய்ச்சிக்கு மட்டுமேயானவை அல்லது பதிவு தேவைப்படும்.
சிறந்த ஆவணம் மற்றும் படிவ OCR தரவுத்தொகுப்புகள் யாவை?
ஆவண OCR தரவுத்தொகுப்புகள், விலைப்பட்டியல்கள், படிவங்கள், ரசீதுகள் மற்றும் அடையாள எண்கள் போன்ற கட்டமைக்கப்பட்ட பக்கங்களைப் பகுப்பாய்வு செய்ய மாதிரிகளுக்குப் பயிற்சி அளிக்கின்றன. இவை வணிக ஆவணத் தானியக்கம் மற்றும் திறவு-மதிப்புப் பிரித்தெடுத்தலுக்கு ஆற்றலளிக்கின்றன.
- நிதி — இரைச்சலான, நிஜ உலகத் தோற்றத்துடன் கூடிய, குறிப்புகள் சேர்க்கப்பட்ட 199 ஸ்கேன் செய்யப்பட்ட படிவங்கள். படிவத்தைப் புரிந்துகொள்வதற்கும், திறவு மதிப்புகளைப் பிரித்தெடுப்பதற்குமான ஒரு தரமான அளவுகோல்.
- சோய் — சுமார் 1,000 ரசீதுகளைக் கொண்ட ICDAR 2019 ஸ்கேன் செய்யப்பட்ட ரசீது தரவுத்தொகுப்பு, ஒரே தொகுப்பில் உரை கண்டறிதல், அடையாளம் காணுதல் மற்றும் தகவல் பிரித்தெடுத்தல் ஆகியவற்றை ஆதரிக்கிறது.
- தண்டு — விலைப்பட்டியல் மற்றும் ரசீது தானியக்கத்திற்கான விரிவான புல-நிலை லேபிள்களுடன், OCR-க்குப் பிந்தைய பகுப்பாய்விற்காக உருவாக்கப்பட்ட ஒரு ஒருங்கிணைக்கப்பட்ட ரசீது தரவுத்தொகுப்பு.
- XFUND — FUNSD-இன் பன்மொழி நீட்டிப்பு, ஜெர்மன், ஸ்பானிஷ், பிரெஞ்சு, இத்தாலியன், ஜப்பானிய, போர்த்துகீசிய, சீன ஆகிய ஏழு மொழிகளை உள்ளடக்கியது, ஒவ்வொன்றும் 199 பக்கங்களைக் கொண்டது. பன்மொழி ஆவண செயற்கை நுண்ணறிவுக்கு மிகவும் உகந்தது.
- டிடிஐ-100 சாய்வு, மங்கல் மற்றும் இரைச்சல் போன்ற நிஜ உலகச் சிதைவுகளின் கீழ், கண்டறிந்து அடையாளம் காண்பதற்காகச் சுமார் 100,000 சிதைக்கப்பட்ட ஆவணப் படங்கள்.
சிறந்த காட்சி உரை OCR தரவுத்தொகுப்புகள் யாவை?
அடையாளப் பலகைகள், பொருட்கள் மற்றும் தெருக் காட்சிகள் போன்ற இயற்கையான படங்களில் உள்ள உரையைப் படிப்பதற்காக, காட்சி-உரை OCR தரவுத்தொகுப்புகள் மாதிரிகளுக்குப் பயிற்சி அளிக்கின்றன. பின்னணிகள் ஒழுங்கற்றதாக இருக்கும் கள OCR-க்கு இவை இன்றியமையாதவை.
- ICDAR வலுவான வாசிப்பு சொல் அளவிலான எல்லைப் பெட்டிகள் மற்றும் ஒலிபெயர்ப்புகளுடன் கூடிய 'கவனக்குவிக்கப்பட்ட' மற்றும் 'தற்செயலான காட்சி உரை' சவால்கள் உட்பட, பெரும்பாலான காட்சி-உரை ஆய்வுகளுக்குப் பின்னால் உள்ள அளவுகோல் குடும்பம்.
- கோகோ-உரை — MS-COCO படங்களின் மீது பதிக்கப்பட்ட பெரிய அளவிலான காட்சி-உரை விளக்கக் குறிப்புகள். இயற்கைக் காட்சிகளில் பெரிய அளவில் உரையைக் கண்டறிவதற்கு வலிமையானது.
- முழு உரை — பழைய OCR மாடல்களின் அறியப்பட்ட பலவீனமான பகுதியான, வளைந்த மற்றும் தன்னிச்சையாக அமைந்த எழுத்துக்களைக் கையாள்வதில் நிபுணத்துவம் பெற்றது.
- SVT (தெருக் காட்சி உரை) கூகிள் ஸ்ட்ரீட் வியூவிலிருந்து எடுக்கப்பட்ட வார்த்தைப் படங்கள்; இவை பெரும்பாலும் குறைந்த தெளிவுத்திறனையும் அதிக மாறுபாடுகளையும் கொண்டவை. பேப்பர்ஸ் வித் கோட் மிரர்கள் வழியாகக் கிடைக்கின்றன.
- படிநிலை உரை — கையால் எழுதப்பட்ட மற்றும் அச்சிடப்பட்ட காட்சி உரைகள் இரண்டையும் உள்ளடக்கிய, பத்தியிலிருந்து வரிக்கும் சொல்லுக்கும் இடையிலான படிநிலை விளக்கக் குறிப்பு. தளவமைப்பு-உணரும் OCR-க்கு பயனுள்ளது.
சிறந்த இலக்க மற்றும் எழுத்து OCR தரவுத்தொகுப்புகள் யாவை?
இலக்க மற்றும் எழுத்து OCR தரவுத்தொகுப்புகள், கட்டுப்படுத்தப்பட்ட சூழல்களில் தனிப்பட்ட குறியீடுகளை அடையாளம் காண மாதிரிகளுக்குப் பயிற்சி அளிக்கின்றன. இவை வகைப்பாட்டு அடிப்படைகளுக்கான நிலையான தொடக்கப் புள்ளிகளாகும்.
- MNIST — 70,000 சாம்பல்நிற கையெழுத்து இலக்கப் படங்கள். ஒரு இலக்க வகைப்படுத்தியைச் சரிபார்ப்பதற்கான மிக வேகமான அடிப்படை.
- EMNIST — NIST சிறப்புத் தரவுத்தளம் 19-இலிருந்து பெறப்பட்ட 814,255 கையெழுத்துக் கடிதங்கள் மற்றும் இலக்கங்களைக் கொண்டு MNIST-ஐ விரிவுபடுத்துகிறது.
- SVHN (தெருக்காட்சி வீட்டு எண்கள்) — வீட்டு எண்களிலிருந்து பெறப்பட்ட 600,000 லட்சத்திற்கும் மேற்பட்ட நிஜ உலக இலக்கப் படங்கள். இரைச்சல் மிகுந்த சூழல்களுக்கு, MNIST-ஐ விட இது ஒரு நடைமுறைக்கு உகந்த மேம்பாடு ஆகும்.
- சார்ஸ்74கே — இயற்கை படங்கள் மற்றும் கணினி எழுத்துருக்களிலிருந்து எடுக்கப்பட்ட, ஆங்கிலம் மற்றும் கன்னட எழுத்துக்களை உள்ளடக்கிய 74,107 படங்கள்.
- NIST சிறப்பு தரவுத்தளம் 19 — 3,600 எழுத்தாளர்களிடமிருந்து பெறப்பட்ட 810,000-க்கும் மேற்பட்ட கையால் அச்சிடப்பட்ட கதாபாத்திரப் படங்கள். பல ஆங்கில OCR அளவுகோல்கள் இதிலிருந்தே பெறப்படுகின்றன.
OCR-க்கு சிறந்த கையெழுத்து தரவுத்தொகுப்புகள் யாவை?
கையெழுத்துத் தரவுத்தொகுப்புகள், வளைந்த எழுத்து, அச்சு எழுத்து மற்றும் வரலாற்று கையெழுத்து உரைகளைப் படிப்பதற்காக OCR மாதிரிகளுக்குப் பயிற்சி அளிக்கின்றன. மிகவும் வலிமையான திறந்த கையெழுத்துத் தரவுத்தொகுப்புகளே, கையெழுத்து உரை அறிதலுக்கான (HTR) மிகவும் அதிகமாக மேற்கோள் காட்டப்படும் அளவுகோல்களாகத் திகழ்கின்றன.
- ஐஏஎம் கையெழுத்து தரவுத்தளம் — 657 எழுத்தாளர்களிடமிருந்து பெறப்பட்ட 13,353 உரை வரிகளைக் கொண்ட, ஆங்கிலக் கையெழுத்தின் பொன் தரநிலை. 2024–2025 OCR ஆய்வில், இதுவே இன்றும் அதிகம் மேற்கோள் காட்டப்படும் கையெழுத்துத் தரவுத்தொகுப்பாகும்.
- IAM-OnDB — பாதைத் தரவைப் பதிவுசெய்யும் IAM-இன் இணையவழிப் பேனா-கோட்டுப் பதிப்பு. ஸ்டைலஸ் மற்றும் டேப்லெட் அங்கீகாரத்திற்கான செம்மையான கையெழுத்துத் தரவுத்தொகுப்பு.
- பெந்தம் ஆவணங்கள் — தத்துவஞானி ஜெர்மி பெந்தாமின் படியெடுக்கப்பட்ட வரலாற்று ஆங்கிலக் கையெழுத்துப் பிரதிகள். வரலாற்று கையெழுத்து OCR-க்கான முன்னணி அளவுகோல், டிரான்ஸ்கிரிபஸ் வழியாக அணுகக்கூடியது.
- GNHK (குட்நோட்ஸ் கையெழுத்துப் பயிற்சித் தொகுப்பு) — கட்டுப்பாடற்ற, நிஜ உலக ஆங்கிலக் கையெழுத்துக் குறிப்புகளின் 2021 தரவுத்தொகுப்பு. ஆய்வகத் தூய்மையான IAM-ஐ விட, ஒழுங்கற்ற உற்பத்தித் தரவுகளுக்கு இது நெருக்கமானது.
சிறந்த பன்மொழி மற்றும் லத்தீன் அல்லாத OCR தரவுத்தொகுப்புகள் யாவை?
பன்மொழி OCR தரவுத்தொகுப்புகள், ஆங்கிலம் அல்லாத சீனம், அரபு மற்றும் கணிதக் குறியீடுகள் உள்ளிட்ட எழுத்துமுறைகளில் மாதிரிகளுக்குப் பயிற்சி அளிக்கின்றன. உலகளாவிய ஆவணம் மற்றும் கையெழுத்து அறிதலுக்கு இவை இன்றியமையாதவை.
- CASIA-HWDB — 1,020 எழுத்தாளர்களிடமிருந்து பெறப்பட்ட 1.17 மில்லியன் கையெழுத்து எழுத்து மாதிரிகளைக் கொண்ட, தரமான சீன OCR அளவுகோல்.
- கட் — 1,000 வெவ்வேறு எழுத்தாளர்களிடமிருந்து பெறப்பட்ட 1,000 அரபு கையெழுத்துப் படிவங்கள், பல்வேறு தெளிவுத்திறன்களில் ஸ்கேன் செய்யப்பட்டுள்ளன. இதுவே மிகவும் விரிவான திறந்தநிலை அரபு OCR தரவுத்தொகுப்பாகும்.
- க்ரோம் — இணையவழி கையெழுத்து கணித கோவைகளை அடையாளம் காணும் போட்டி: 101-க்கும் மேற்பட்ட கணிதக் குறியீடுகளைக் கொண்ட 10,000-க்கும் மேற்பட்ட கோவைகள், இணையவழி மற்றும் நேரடி வடிவங்களில் கிடைக்கின்றன. கையெழுத்து சமன்பாடுகளை இணையத்தில் அடையாளம் காண இது இன்றியமையாதது.
இலவச OCR தரவுத்தொகுப்புகளைப் பயன்படுத்தும்போது ஏற்படும் பொதுவான சிக்கல்கள் யாவை?
பெரும்பாலான அணிகள் மூன்று இடர்ப்பாடுகளைச் சந்திக்கின்றன.
டொமைன் பொருத்தமின்மை: தூய்மையான IAM அல்லது COCO-Text-இல் பயிற்சி அளித்து, சுருக்கப்பட்ட இன்வாய்ஸ்களில் செயல்படுத்துவது, துல்லியத்தன்மை குறைவாக இருப்பதை உறுதி செய்கிறது.
உரிம மறைப்பு: பல காட்சி-உரை மற்றும் வரலாற்று OCR தரவுத்தொகுப்புகள் ஆராய்ச்சிக்கு மட்டுமேயானவை அல்லது வணிகப் பயன்பாட்டிற்கு முன் பதிவு செய்யப்பட வேண்டும்.
விளக்கக் குறிப்பு இடைவெளிகள்: பல OCR தரவுத்தொகுப்புகளில், உற்பத்தி அமைப்புகளுக்குத் தேவைப்படும் தளவமைப்பு மெட்டாடேட்டா, வரி-நிலை எல்லைப் பெட்டிகள் அல்லது புலக் குறியீடுகள் இல்லை.
சரக்கு அனுப்பும் லேபிள்களைத் தானியங்குபடுத்தும் ஒரு நடுத்தர அளவிலான தளவாட நிறுவனத்தைக் கற்பனை செய்து பாருங்கள். பொதுவான காட்சி-உரை பயிற்சியானது, அளவுகோல் சோதனைகளில் அவர்களை 80% செயல்திறனை அடையச் செய்கிறது, ஆனால் ஒளிப் பிரதிபலிப்பு மற்றும் மடிப்புகள் கொண்ட உண்மையான லேபிள்கள் அவர்களின் செயல்திறனை 58% ஆகக் குறைத்துவிடுகின்றன. அந்த இடைவெளியைக் குறைப்பதற்கு, இந்தச் செயல்முறையைத் தொடங்குவதற்கு முன்பு, அதே களத்தைச் சேர்ந்த 6,000 லேபிள் படங்களுக்கு இலக்கு வைக்கப்பட்ட தரவுக் குறிப்பீடு தேவைப்பட்டது.
திறந்த மூல தரவுத்தொகுப்புகளின் நன்மைகள் மற்றும் சவால்கள்
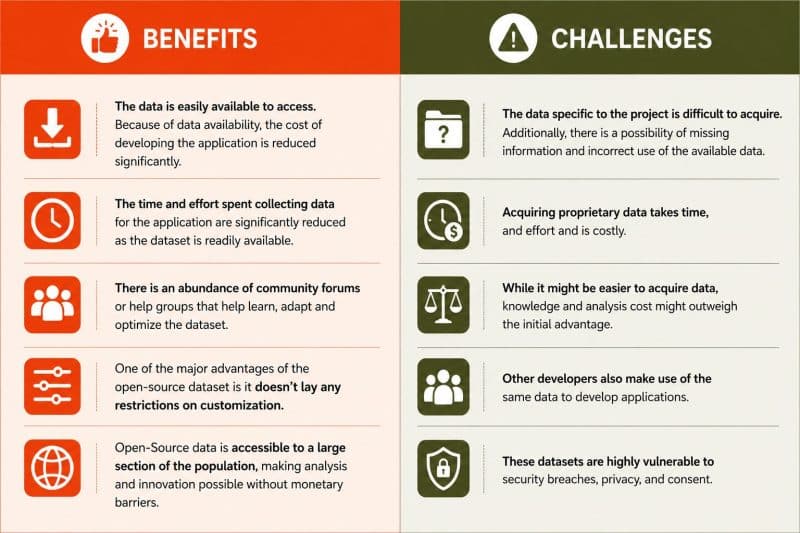
வணிகங்கள் தங்கள் ML பயன்பாடுகளுக்கு இலவசமாகப் பயன்படுத்தக்கூடிய தரவைத் தேர்வு செய்ய வேண்டுமா என்பதைப் புரிந்துகொள்வதற்கு, நன்மைகள் மற்றும் சவால்களை ஒன்றுக்கொன்று எதிராகப் போட்டியிட வேண்டும்.
நன்மைகள்
- தரவு அணுகுவதற்கு எளிதாகக் கிடைக்கிறது. தரவு கிடைப்பதால், பயன்பாட்டை உருவாக்கும் செலவு கணிசமாகக் குறைக்கப்படுகிறது.
- தரவுத்தொகுப்பு உடனடியாகக் கிடைப்பதால், பயன்பாட்டிற்கான தரவைச் சேகரிக்கும் நேரமும் முயற்சியும் கணிசமாகக் குறைக்கப்படுகிறது.
- தரவுத்தொகுப்பைக் கற்கவும், மாற்றியமைக்கவும் மற்றும் மேம்படுத்தவும் உதவும் சமூக மன்றங்கள் அல்லது உதவிக் குழுக்கள் ஏராளமாக உள்ளன.
- திறந்த மூல தரவுத்தொகுப்பின் முக்கிய நன்மைகளில் ஒன்று, இது தனிப்பயனாக்கலில் எந்த கட்டுப்பாடுகளையும் விதிக்காது.
- திறந்த மூல தரவு மக்கள் தொகையில் பெரும் பகுதியினருக்கு அணுகக்கூடியது, பணத் தடைகள் இல்லாமல் பகுப்பாய்வு மற்றும் கண்டுபிடிப்புகளை சாத்தியமாக்குகிறது.
சவால்கள்
- திட்டத்திற்கு குறிப்பிட்ட தரவு பெறுவது கடினம். கூடுதலாக, தகவல்களைக் காணவில்லை மற்றும் கிடைக்கக்கூடிய தரவை தவறாகப் பயன்படுத்துவதற்கான வாய்ப்பு உள்ளது.
- தனியுரிமத் தரவைப் பெறுவதற்கு நேரமும் முயற்சியும் தேவை மற்றும் விலை அதிகம்
- தரவைப் பெறுவது எளிதாக இருந்தாலும், அறிவு மற்றும் பகுப்பாய்வு செலவு ஆரம்ப நன்மையை விட அதிகமாக இருக்கலாம்.
- பயன்பாடுகளை உருவாக்க மற்ற டெவலப்பர்களும் அதே தரவைப் பயன்படுத்துகின்றனர்.
- இந்த தரவுத்தொகுப்புகள் பாதுகாப்பு மீறல்கள், தனியுரிமை மற்றும் ஒப்புதல் ஆகியவற்றால் மிகவும் பாதிக்கப்படக்கூடியவை.
ஷைப், OCR மற்றும் கையெழுத்து அறிதல் திட்டங்களுக்கு எவ்வாறு ஆதரவளிக்கிறது?
ஷைப்பின் OCR பயிற்சித் தரவுச் சேவைகள் , அச்சிடப்பட்ட ஆவணங்கள், கையெழுத்து, ரசீதுகள் மற்றும் அடையாள அட்டைகள் என 60-க்கும் மேற்பட்ட மொழிகளில், திறந்த தரவுத்தொகுப்புத் தொகுப்பைத் தனிப்பயன் தரவுச் சேகரிப்புடன் இணைக்கின்றன . ஷைப்பின் குறிப்புரை பணிப்பாய்வுகள், பொது OCR தரவுத்தொகுப்புகளில் விடுபட்டிருக்கும் வரி-நிலை எல்லைப் பெட்டிகள், புலம்-நிலை லேபிள்கள், படியெடுத்தல் தரக்கட்டுப்பாடு மற்றும் எழுத்தாளர் மெட்டாடேட்டா போன்ற அடுக்குகளைச் சேர்க்கின்றன.
தீர்மானம்
மேலே உள்ள 22 OCR தரவுத்தொகுப்புகள், 2026-ஆம் ஆண்டிற்கான ஆவணம், காட்சி உரை, இலக்கம், கையெழுத்து மற்றும் பன்மொழி அங்கீகாரம் ஆகிய துறைகளில் ஒரு முழுமையான திறந்த மூல அடித்தளத்தை உங்களுக்கு வழங்குகின்றன. உங்கள் உரை வகை மற்றும் பதிவுச் சூழலுடன் பொருந்தக்கூடிய OCR தரவுத்தொகுப்பிலிருந்து தொடங்கி, உங்கள் உண்மையான தரவின் ஒரு குறிப்பிட்ட மாதிரியுடன் அதைச் சரிபார்த்து, துறை இடைவெளியைக் குறைக்க தனிப்பயன் குறிப்பீட்டிற்காக நிதி ஒதுக்கீடு செய்யுங்கள். இந்த ஒருங்கிணைப்பு, புதிதாக உருவாக்குவதை விட வேகமாகச் செயல்படுத்தப்படும்.